

El costo de ser breve
Una comparación exploratoria de Ponytail, Caveman y Chisle: 425 ejecuciones válidas de 480 previstas, respuestas finales más cortas y estimaciones mixtas de costo por sesión.
01 / Qué quería averiguar
Qué quería averiguar
Una respuesta final más corta se agradece al leer. También resulta tentador usarla como indicador del costo de una sesión con un agente. Quería saber si las skills que promueven respuestas breves o cambios más pequeños reducían la cuenta completa sin omitir trabajo útil.
Comparamos Ponytail, Caveman y Chisle. Ponytail pide el cambio completo más pequeño y sus verificaciones. Caveman comprime la prosa. Chisle combina respuestas breves con disciplina de código y contexto. Nuestro equipo ya usa Ponytail: es un conflicto de interés que debemos declarar, no una razón para favorecer sus resultados.
Este es un informe exploratorio de un experimento incompleto con un solo identificador de modelo. La observación es acotada: las respuestas finales más cortas no predijeron de forma consistente un menor costo reportado por sesión en estas tareas. No establece una skill ganadora ni una política de adopción para toda la empresa.
Dirección e interpretación de la investigación: Fernando Ramos. El equipo de agentes de Claude preparó y ejecutó el experimento nocturno. Codex recuperó la evidencia, corrigió el evaluador, volvió a evaluar las salidas guardadas y verificó el análisis. Distinguimos esas contribuciones del trabajo manual de una persona.
02 / Qué ejecutamos
Qué ejecutamos
El diseño incluyó ocho configuraciones: sin skill, cada skill por separado, cada pareja y las tres juntas. Planeamos cinco repeticiones de cada configuración en 12 tareas: 480 combinaciones de tarea, configuración y repetición. El piloto anterior de 64 ejecuciones es otro conjunto de datos y no se mezcla con esta comparación.
Cada tarea recibió la misma solicitud y un repositorio nuevo. Las filas válidas registran claude-sonnet-5-5, con esfuerzo medio, en Claude Code 2.1.286. El identificador es un dato de control registrado, no una garantía de que los pesos del proveedor sean inmutables. El orden de ejecución se mezcló con una semilla fija.
La batería cubrió errores de paginación y dinero, reintentos, refactorización, cambio de una variable de configuración, elección de dependencias, verificación HMAC, revisión de código, explicación y tres tareas de comunicación. Las verificaciones automatizadas usaron pruebas ocultas o rúbricas de hechos requeridos. Comprobamos cada evaluador con un caso incorrecto conocido y uno correcto.
Las tres skills usaron el mismo mecanismo de inyección de texto. Las tareas de revisión incluyeron también el complemento de revisión de cada paquete. Los hooks, la compresión de salidas y otras integraciones estaban inactivos. El experimento compara los conjuntos de texto fijados a commits, no todas las funciones de esos paquetes. Los commits y licencias aparecen en el registro de versiones y las fuentes.
Los doce retos
Estos son los identificadores originales y sus retos, según las definiciones task.json del paquete de investigación.
| ID de tarea | Trabajo solicitado |
|---|---|
bugfix_pagination | Corregir índices y páginas parciales; actualizar la compensación que usaba el código llamador. |
bugfix_money | Aplicar el redondeo contable de mitades hacia arriba por línea y después del impuesto. |
feature_retry | Limitar a tres intentos los errores transitorios, sin reintentar PermanentError, e inyectar la espera. |
refactor_dedupe | Compartir exportación CSV, conservando funciones públicas y el entrecomillado correcto. |
scope_rename | Cambiar DB_URL por DATABASE_URL en código y documentación, conservando la prioridad y el respaldo. |
dependency_choice | Interpretar fechas ISO con zona horaria en Python 3.11+ y decidir si hace falta otra dependencia. |
security_webhook | Verificar HMAC-SHA256, rechazar entradas malformadas y comparar en tiempo constante. |
review_diff | Revisar un diff sin aplicar: inyección SQL, una fila extra y fallas de base de datos ocultas. |
explain_code | Explicar un token bucket e identificar el truncamiento de recarga y la falta de seguridad entre hilos. |
comm_incident | Redactar un aviso al cliente con alcance, alternativa de pago, cargos y horarios inciertos. |
comm_pr_description | Explicar una API eliminada, el nuevo timeout, los reintentos y la migración de llamadas. |
comm_tradeoff_pm | Recomendar caché de navegación con validación del precio vigente en checkout. |
Los casos aíslan decisiones pequeñas en archivos Python cortos o hechos suministrados. No evalúan las dependencias de un repositorio grande, migraciones, despliegues ni mantenimiento sostenido. Repetirlos mejora la repetibilidad; no convierte doce ejemplos en evidencia a escala de repositorio.
03 / Respuestas más cortas, costos mixtos
Respuestas más cortas, costos mixtos
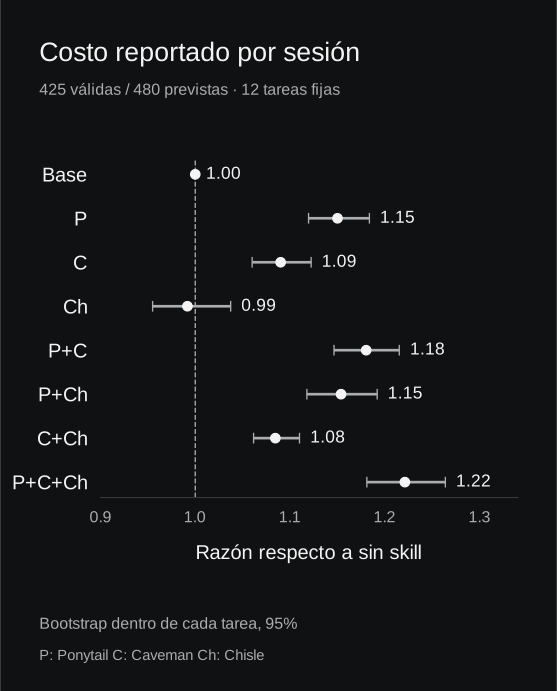
En cada tarea comparamos la media de una configuración con la media de esa tarea sin skill; después dimos el mismo peso a las 12 tareas. Una razón de 1.15 representa una estimación puntual 15% mayor. Los intervalos del 95% usan 2,000 remuestreos bootstrap de las repeticiones base y de tratamiento dentro de cada tarea.
Los intervalos describen variación entre repeticiones de estas tareas fijas. No corrigen los faltantes, las comparaciones múltiples ni nuestra selección de tareas. Tampoco estiman la incertidumbre de todo el trabajo real de programación.
La estimación de costo de Ponytail fue aproximadamente 15% mayor que la base; la de Caveman, 9% mayor. Chisle estuvo cerca de 1% por debajo, con un intervalo que incluye tanto ahorro como sobrecosto. Combinar las tres produjo una estimación puntual alrededor de 22% mayor.
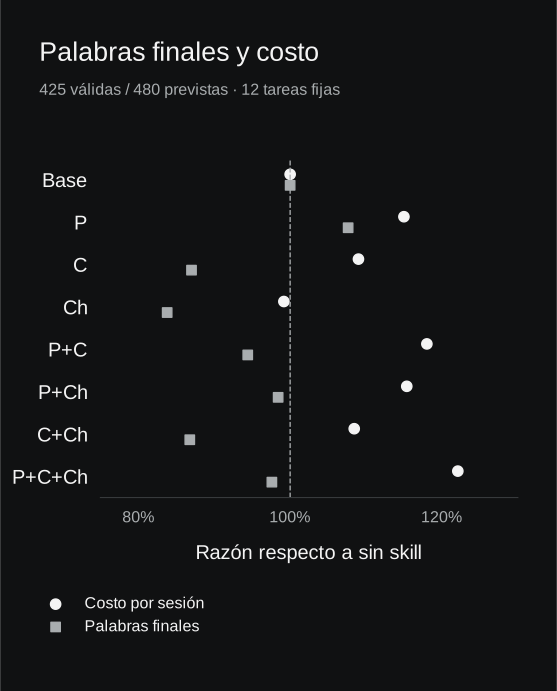
Caveman acortó las respuestas finales aproximadamente 13% y Chisle, 16%, según la estimación normalizada por tarea. La respuesta final es solo una parte de la sesión. El texto de instrucciones, las herramientas, las salidas intermedias y la contabilidad de caché también afectan el costo reportado. Este experimento no aísla cuál de esos componentes causó una diferencia.
La comparación numérica
| Configuración | Válidas / previstas | Verificaciones aprobadas | Razón de costo (intervalo 95%) | Razón de palabras finales |
|---|---|---|---|---|
| Sin skill | 57/60 | 54/57 | 1.00 (1.00 a 1.00) | 1.00 |
| Ponytail | 50/60 | 50/50 | 1.15 (1.12 a 1.18) | 1.08 |
| Caveman | 53/60 | 52/53 | 1.09 (1.06 a 1.12) | 0.87 |
| Chisle | 54/60 | 54/54 | 0.99 (0.96 a 1.04) | 0.84 |
| Ponytail + Caveman | 54/60 | 51/54 | 1.18 (1.15 a 1.22) | 0.94 |
| Ponytail + Chisle | 51/60 | 51/51 | 1.15 (1.12 a 1.19) | 0.98 |
| Caveman + Chisle | 53/60 | 53/53 | 1.08 (1.06 a 1.11) | 0.87 |
| Las tres | 53/60 | 52/53 | 1.22 (1.18 a 1.26) | 0.98 |
El CSV completo incluye los intervalos de tokens de salida y palabras finales. El campo outputTokens del CLI es distinto de las palabras de la respuesta final; no inferimos volumen de razonamiento oculto a partir de su longitud. La medida conservada total_tokens suma los campos reportados de entrada, salida, lectura y creación de caché, sin añadir un campo de pensamiento por separado. Las comparaciones del artículo usan el costo del CLI y palabras visibles, no una afirmación sobre razonamiento oculto.
04 / Los faltantes importan
Los faltantes importan
El intento de 480 combinaciones produjo 425 observaciones válidas. Cuarenta y nueve combinaciones devolvieron una respuesta de límite de sesión y seis agotaron el tiempo. Excluimos esas 55 del cálculo de calidad y razones. Son observaciones faltantes, no verificaciones de calidad fallidas. Mezclar el orden de ejecución no elimina ese problema.
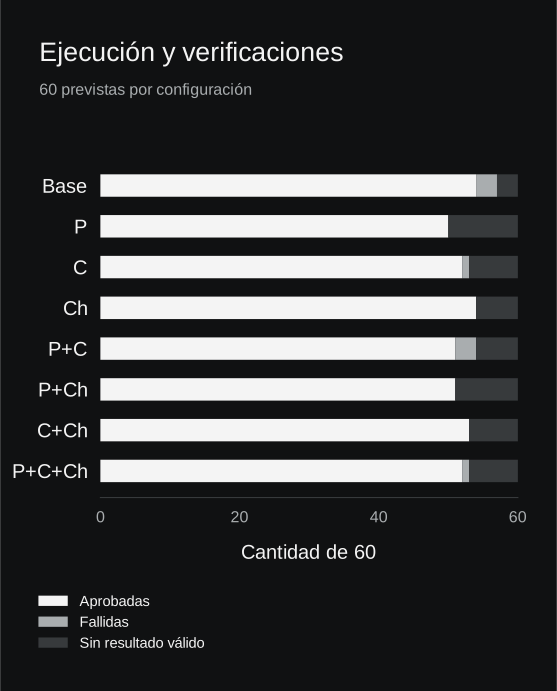
Muchas verificaciones aprobadas no establecen mayor corrección ni seguridad. Los tamaños desiguales, las tareas sintéticas pequeñas y las rúbricas basadas en expresiones regulares limitan esa interpretación. El panel de jueces automatizados también está incompleto: Codex devolvió 168 evaluaciones válidas y Claude, 120; fallaron 48 evaluaciones de Claude. El estilo puede revelar una configuración pese a las etiquetas anónimas. No usamos ese panel parcial para anunciar un ganador de calidad. El registro anterior no conserva la identidad resuelta del modelo de cada juez; los valores por defecto actuales no bastan para establecerla.
El registro reporta USD 16.13 para los intentos del modelo evaluado, según la contabilidad de precios de lista de Claude Code. No es una factura conciliada ni el costo total de la investigación. No incluye los jueces ni cargos no reportados de los intentos que agotaron su tiempo.
05 / Qué podemos concluir
Qué podemos concluir
En las 425 observaciones válidas de este diseño de 480 combinaciones con Sonnet 5.5, Caveman acortó las respuestas finales alrededor de 13%, con un costo de sesión reportado 9% mayor. Chisle quedó cerca del costo base y Ponytail tuvo una estimación puntual 15% mayor. Brevedad y eficiencia son resultados distintos aquí. Los faltantes y la evaluación incompleta no permiten declarar un ganador de calidad ni que el costo adicional haya comprado mejor ingeniería.
Hipótesis que estos datos aún no distinguen
Un modelo nuevo podría aplicar buenas prácticas sin recordatorios. Repetir consejos podría añadir procesamiento, obligaciones de formato o trabajo de conciliación de instrucciones con poco beneficio marginal; modelos anteriores o con menor desempeño base podrían beneficiarse más. Son explicaciones sin comprobar. La latencia y los tokens no revelan un proceso interno de conciliación.
| Hipótesis | Medición | Control o contraste |
|---|---|---|
| Más longitud de instrucciones añade costo de procesamiento. | Tokens de entrada y tiempo al primer token, cuando esté disponible. | Tarea sola frente a un apéndice neutral de longitud equivalente a la skill. |
| La entrada repetida y la caché explican el costo. | Entrada por turno, lecturas/escrituras de caché y entrada sin caché. | Registrar cada solicitud; comparar prefijos equivalentes y separar estados de caché. |
| Las skills inducen trabajo de ingeniería adicional. | Herramientas, pruebas ejecutadas, cambios y aceptación. | Fijar tarea y verificaciones; examinar si el trabajo extra corrige un problema demostrado. |
| Los consejos y el formato tienen efectos distintos. | Requisitos cubiertos, cumplimiento de formato y uso. | Núcleo conciso con relleno neutral frente al mismo núcleo con obligaciones de formato, a igual longitud. |
| El beneficio depende de la generación y capacidad base. | Cambio del efecto de la skill y de prácticas base dentro de cada familia. | Versiones anteriores/nuevas, mismo harness y tareas; medir capacidad aparte de la fecha de lanzamiento. |
FollowBench distingue restricciones de contenido, situación, estilo, formato y ejemplo. Motiva medir cumplimiento aparte del resultado útil; no demuestra estos mecanismos. La internalización de estas skills específicas durante el entrenamiento no se puede comprobar aquí sin conocer la procedencia del entrenamiento o controlar la exposición. La convergencia de comportamiento no identifica los textos que recibió un modelo.
06 / Tuvimos que corregir el evaluador
Tuvimos que corregir el evaluador
Una revisión independiente detectó un fallo real de aislamiento. Al terminar la sesión Bash del modelo, el evaluador importaba Python generado mediante un proceso ordinario del equipo anfitrión. El directorio era temporal, pero el proceso conservaba acceso al equipo. El sandbox Bash del modelo no protegía al evaluador posterior.
Codex corrigió el evaluador y el procesamiento de Git para ejecutarlos dentro de un sandbox del sistema operativo de macOS. Rechazó enlaces simbólicos generados y evaluó copias desechables reconstruidas a partir de los parches guardados. Las pruebas verifican que no se puede leer ni sobrescribir un archivo de prueba externo, que TCP está bloqueado y que una escritura al importar código no cambia el archivo testigo del anfitrión. Siguen siendo legibles rutas explícitas del sistema y del runtime, además de metadatos del sistema de archivos. No es una máquina virtual ni una garantía de que todo acceso externo sea imposible.
Después volvimos a evaluar las 425 salidas válidas dentro del aislamiento. No cambió ningún resultado de aprobación o falla. Pasan ocho pruebas focalizadas de seguridad y análisis, y los 12 evaluadores distinguen sus casos incorrectos y correctos. Una revisión independiente verificó las 425 huellas actuales de evaluador, tarea y artefactos. Esto respalda las verificaciones recuperadas; no aísla retroactivamente las ejecuciones originales ni demuestra el confinamiento completo de cada herramienta del modelo.
Conservamos los registros originales. La recuperación no hizo nuevas llamadas a modelos. También corregimos el análisis: el bootstrap original dejaba fijas las medias base observadas; el análisis recuperado remuestrea esas observaciones. La tabla de este artículo reemplaza los intervalos anteriores y las afirmaciones de efectos factoriales.
07 / Examina la evidencia
Examina la evidencia
Descarga el ZIP de la investigación, SHA-256 del archivo, manifiesto de archivos, auditoría recuperada, CSV agregado, observaciones depuradas en JSONL y procedencia de las figuras.
El ZIP contiene el texto fijado de las skills con sus licencias, los casos de prueba, el evaluador corregido, el análisis numérico y las 480 observaciones más recientes depuradas. Las 55 excluidas tienen resultados de calidad nulos. No incluye transcripciones crudas, metadatos de sesión o autenticación, registros nocturnos mutables ni los parches y respuestas individuales. Permite recalcular el análisis numérico; repetir la evaluación desde los parches requiere el archivo interno conservado. Dos cambios de portabilidad en el código exportado eliminan rutas particulares del equipo sin cambiar la lógica del evaluador; el archivo los documenta.
Para reproducir las razones numéricas después de extraer el ZIP:
python3 -B harness/analyze_observations.pyDescarga el generador y los datos de las figuras con su SHA-256 separado. Usa Matplotlib 3.10.9 solo al generar los archivos, sin añadir una dependencia al sitio en ejecución. Las figuras se generan directamente del CSV. El generador compara los conteos con las observaciones depuradas, comprueba que cada intervalo mostrado contiene su estimación y registra las huellas de los archivos fuente. El SHA-256 del ZIP de investigación es 126ea810d22e809a0c403c521120f32d7ac936d81ca80fbc83a0c07f5c441eee.
08 / Qué mediría después
Qué mediría después
Elige una skill por el comportamiento que necesitas y mide sesiones completas en trabajo representativo de tu equipo. Una reducción anunciada de prosa no establece una reducción de la cuenta; este subconjunto incompleto tampoco justifica adoptar o descartar una skill en toda la empresa.
Faltan 55 combinaciones del modelo evaluado y 48 evaluaciones de jueces. Completarlas requiere la misma configuración y cuota disponible. Una extensión prevista usaría un ciclo común de herramientas por HTTP entre modelos, con skills, herramientas, límites de turnos y casos aislados fijos. Ese harness difiere de Claude Code en V1: sus observaciones deben permanecer en otro conjunto de datos. Este artículo no presenta resultados de modelos nuevos.
La siguiente comparación necesita varias dimensiones. Hay que fijar verificaciones de corrección y regresiones fuera del control del generador, y reportar aceptación y fallas antes de comparar estilo. En código: complejidad ciclomática por función, número de funciones, mediana/máximo e incrementos de decisión, sum(CC - 1). Radon añade uno por función; extraer funciones puede cambiar una media por sí solo. Las decisiones de módulo se registran aparte. La complejidad cognitiva puede aproximar comprensibilidad, usando la definición de Sonar como referencia. Hay que nombrar y fijar el analizador: una biblioteca de terceros no equivale al analizador oficial de Sonar ni mide directamente la calidad. Tamaño de código/pruebas, dependencias y líneas añadidas/eliminadas van por separado; pocos cambios también pueden omitir comportamiento.
Usaríamos jueces actuales de frontera de familias distintas y una rúbrica neutral fijada. Recibirían artefactos anónimos, requisitos y verificaciones inmutables, sin skills de tratamiento, etiquetas de configuración ni identidad del generador. Puntuarían corrección, mantenibilidad, alcance y explicación por separado. Invertiríamos el orden de las parejas y revisaríamos desacuerdos: MT-Bench documenta sesgos de posición, verbosidad y preferencia por respuestas propias. El acuerdo de dos jueces no establece la verdad.
Registraríamos latencia total junto con tokens de entrada/salida, caché y razonamiento reportado por el proveedor. Los campos no disponibles quedarían nulos; no inferiríamos razonamiento oculto de longitud o tiempo. Separaríamos costos de generadores y jueces, facturas y estimaciones, conservando intentos fallidos. La eficiencia requiere calidad aceptable con menos tiempo o costo, no solo una respuesta más corta.
09 / Rastro de fuentes
Primarias, frescas, inspeccionables.
Los detalles de producto cambian rápido. Estas fuentes se verificaron para esta edición el 27 de octubre de 2026. Vuelve a verificar antes de cambiar una política de producción.
- 01Ponytail 5.3.2 · pinned sourceDietrich GebertMIT. Text and review companion used in this experiment; installed hooks were not tested.
- 02Caveman · pinned sourceJulius BrusseeApache-2.0; installer version 4.0.1. Pinned text and review companion; hooks inactive.
- 03Chisle 3.8.1 · pinned sourceJay PokaleMIT. Pinned text and review companion; output-compression hook inactive.
Señal semanal · correo quincenal
Ideas probadas en campo. Sin producir contenido por producir.
Una nota sustancial cuando tenemos algo que vale la pena mostrar: sistemas, evidencia, instrucciones y lo que falló. Confirma por correo. Cancela tu suscripción cuando quieras.