

Recuperar una tarea no garantiza un solo correo
Un lease persistente puede recuperar una tarea en segundo plano sin garantizar que un efecto externo ocurra una sola vez. Un experimento de 50 corridas separa la propiedad de la tarea, las solicitudes HTTP y los efectos aceptados.
01 / Qué recupera el lease
Qué recupera el lease
La recuperación de tareas en segundo plano de Mastra y el estado de entrega de un proveedor de correo son dos máquinas de estado distintas. Un proceso puede perder la propiedad de la tarea mientras el destino ya aceptó su solicitud. El lease coordina a los workers que comparten el almacenamiento de tareas; no puede revertir un efecto confirmado por otro sistema.
En @mastra/core@1.72.0, una tarea en ejecución registra un dueño y el vencimiento del lease (ownerId y leaseExpiresAt). El dueño renueva ese lease mientras trabaja. Si el proceso desaparece, otro worker puede recuperar la tarea cuando vence. El adaptador de almacenamiento correspondiente también debe persistir y aplicar esos campos; el paquete core no puede ofrecer por sí solo esa frontera.
El intervalo difícil no es el tiempo anterior a la solicitud. Es el espacio entre la aceptación de una operación por el destino y el momento en que Mastra guarda el resultado de la herramienta y marca la tarea como completada. Si el worker muere ahí, el almacenamiento dice que la tarea sigue pendiente, aunque el destino quizá ya actuó. La recuperación debe avanzar desde el estado que puede observar, no desde una transacción que nunca compartió.
Eso deja dos preguntas distintas:
Propiedad de la tarea: ¿qué worker puede ejecutarla y completarla ahora?
Efecto externo: ¿el destino ya aplicó esta operación lógica?
El lease responde la primera. No responde la segunda. Por eso una tarea puede recuperarse según lo previsto y aun así enviar una solicitud que produzca un efecto duplicado.
Dos máquinas de estado, una ventana de fallo {#failure-window}
El experimento hace visible la frontera con dos bases de datos separadas: un archivo local libSQL para el estado de las tareas de Mastra y un archivo SQLite para un receptor HTTP sintético. El worker solo puede guardar el resultado de la tarea después de que regrese la herramienta; el receptor puede confirmar su efecto antes. Ninguna base de datos puede confirmar o deshacer atómicamente la escritura de la otra.
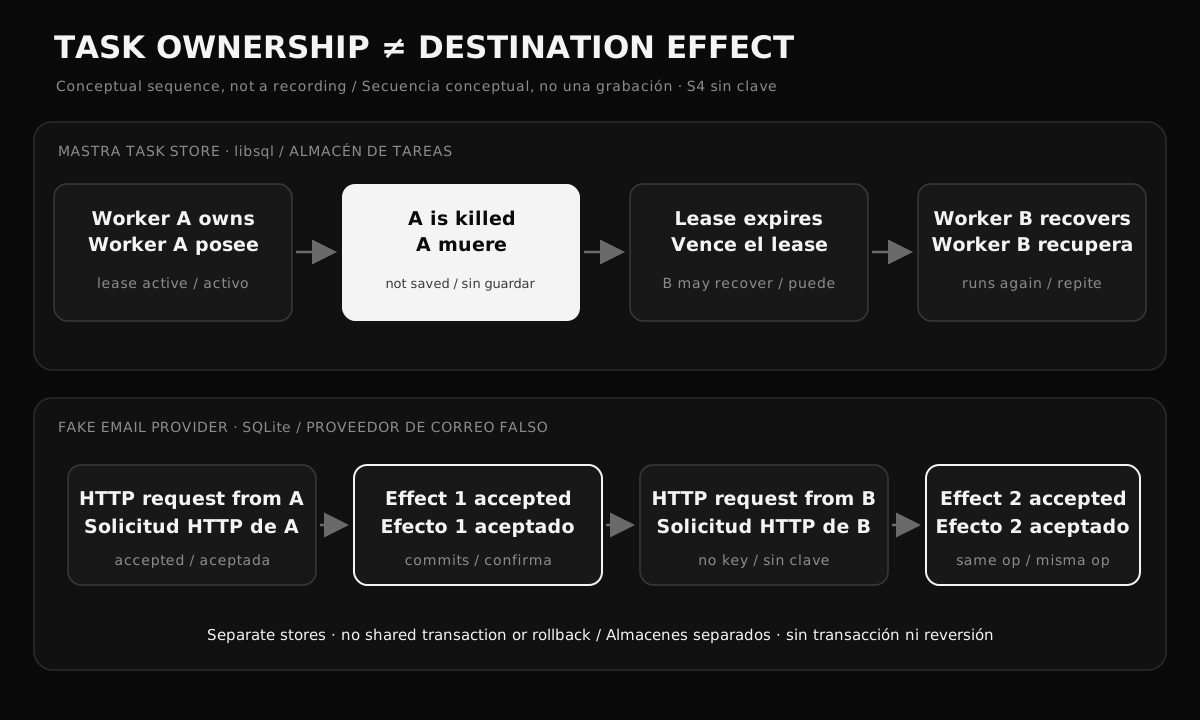
Es un esquema, no una captura de pantalla ni una afirmación sobre el comportamiento de todos los proveedores. Describe la frontera que S4 probó deliberadamente. Si el receptor reconoce una clave de idempotencia estable, puede registrar la solicitud repetida de B como duplicada sin aplicar dos veces la operación lógica. La solicitud sí ocurrió; lo que cambió fue la conducta del destino.
02 / Un experimento controlado de 50 corridas
Un experimento controlado de 50 corridas
La pregunta era acotada: ¿un segundo worker respeta al dueño actual después de una interrupción? ¿Y qué ocurre si la acción externa ya se aceptó? El protocolo, fijado antes de las corridas, define diez escenarios repetidos cinco veces. El experimento usó dos procesos Node separados que compartían un archivo local libSQL. Cada worker tenía su propio pubsub en memoria, así que la coordinación entre procesos dependía del estado persistido, la recuperación al iniciar y el vencimiento del lease, no de un bus de mensajes compartido en memoria.
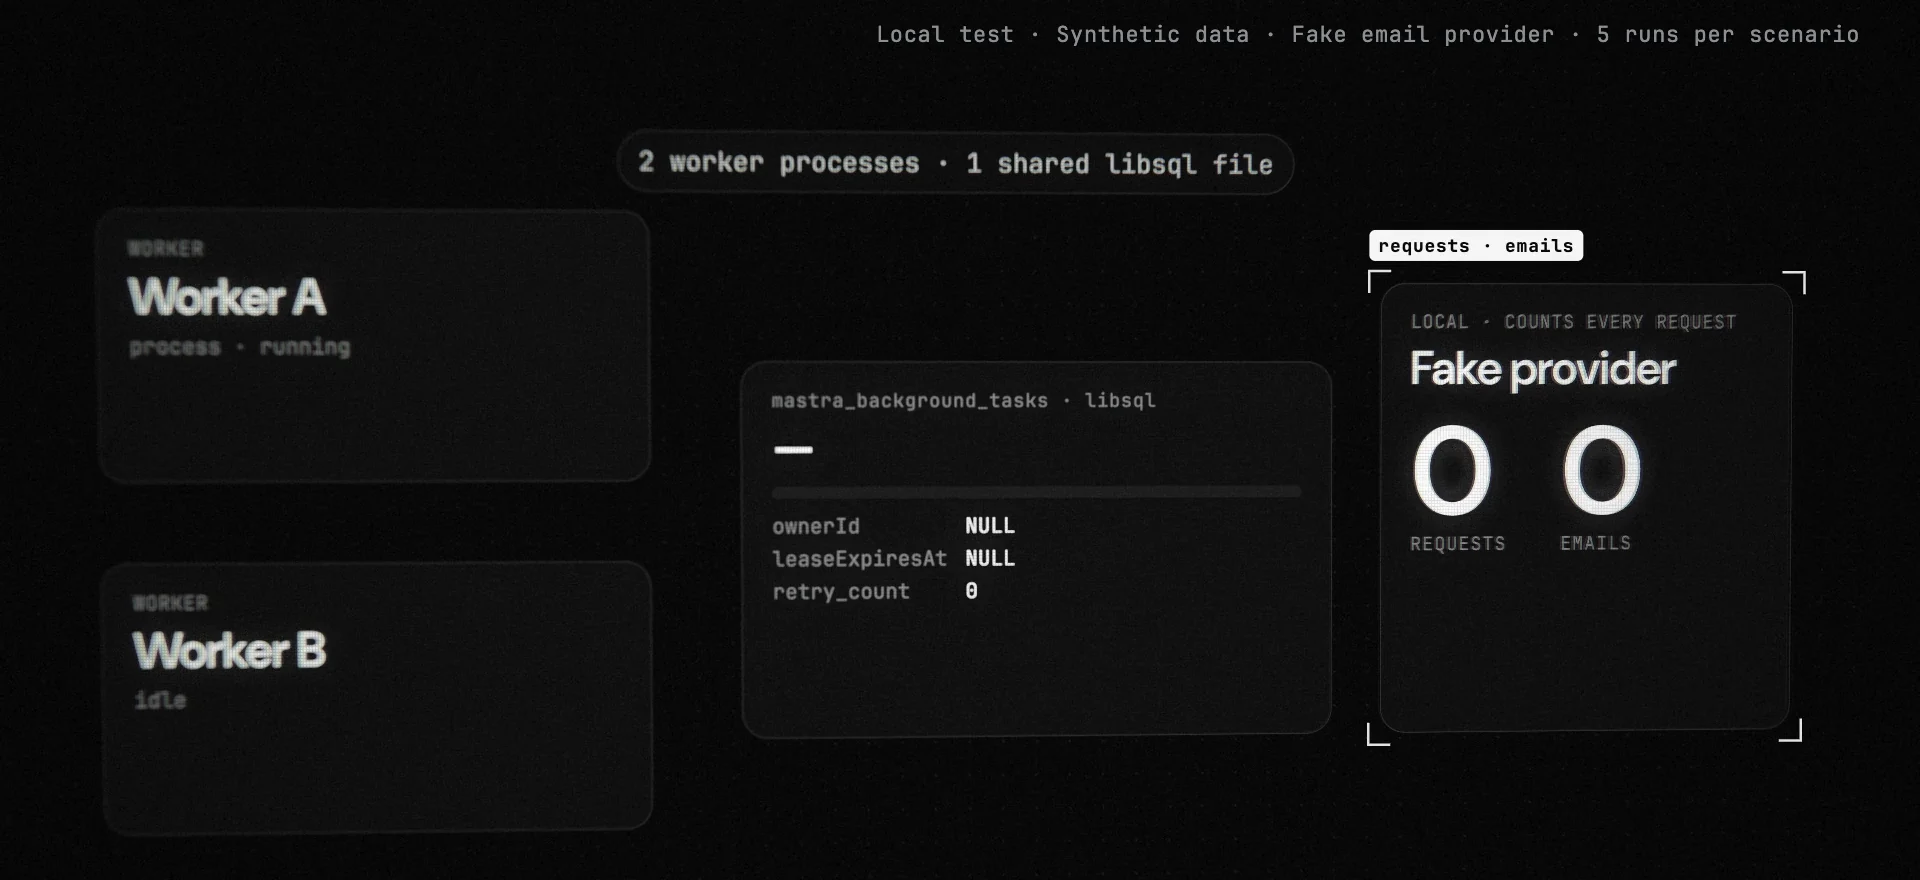
Las tareas se encolaron directamente mediante mastra.backgroundTaskManager.enqueue() y se ejecutaron con un executor estático registrado mediante registerStaticExecutor(). La herramienta send_receipt enviaba una solicitud al receptor HTTP local y esperaba 2.500 ms antes de regresar. Esa espera preservaba el intervalo en que el receptor podía haber actuado, pero el resultado de la tarea todavía no se había guardado. El receptor tenía su propia base SQLite. Registraba cada solicitud HTTP por separado de cada efecto aceptado. En los escenarios con clave, una clave única de idempotencia y una transacción hacían efectivo el primer request con esa clave; los siguientes quedaban registrados como duplicados.
No se envió ningún correo real. El receptor era un sustituto controlado, no una integración con un proveedor. Tampoco se llamó a un modelo ni se pagó por inferencia. Esto prueba transiciones del estado de la tarea y del destino; no prueba el criterio de un agente ni las reglas de entrega de un servicio real de correo.
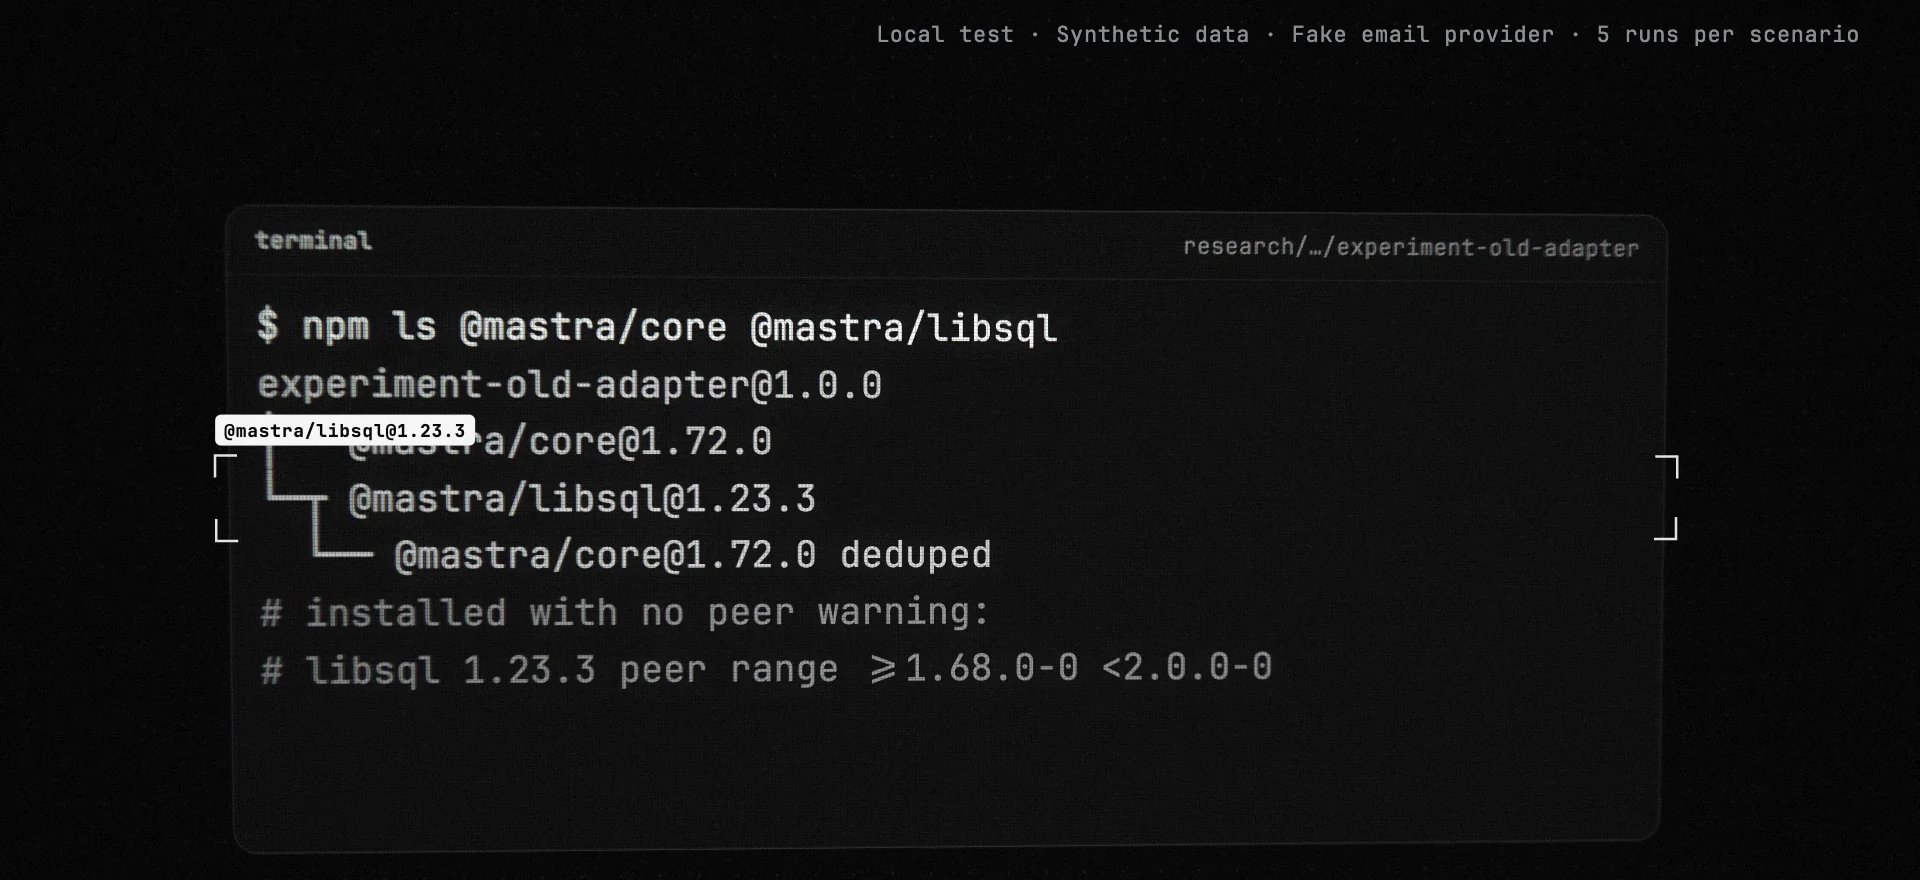
La pareja probada fue @mastra/core@1.72.0 con @mastra/libsql@1.24.0. Un control de compatibilidad emparejó el mismo core con el adaptador anterior @mastra/libsql@1.23.3, cuyo rango declarado de peer dependency permitió instalarlo sin advertencias. El lease duraba 4.000 ms, el intervalo de heartbeat era de aproximadamente 1.333 ms, maxRetries era 1 y el timeout de la tarea era de 60 segundos. El equipo fue un Apple M5 con 24 GB de RAM, macOS Darwin 27.0 y Node v26.0.0.
El protocolo quedó fijado antes de la ronda de cinco repeticiones. Las 50 corridas se clasificaron como observadas: todas tenían evidencia del runtime y del receptor suficiente para clasificarlas. Durante parte del experimento también se ejecutó una compilación de Rust en el mismo equipo. Por eso, los tiempos de recuperación son mediciones de esta máquina local bajo carga, no límites ni estimaciones de la tasa de fallos en producción.
03 / Qué muestran los diez escenarios
Qué muestran los diez escenarios
La tabla informa las solicitudes recibidas y los efectos aceptados por corrida; cada escenario tuvo cinco corridas. Un efecto cuenta solo cuando lo registró el receptor sintético. A y B son procesos worker separados.
| Escenario | Preparación o interrupción | Solicitudes | Efectos | Observación en las cinco corridas |
|---|---|---|---|---|
| S1 | Un worker, sin interrupción | 1 | 1 | Control |
| S2 | B inicia mientras A ejecuta una tarea de 9 s | 1 | 1 | B no ejecutó; A renovó el lease seis veces |
| S3 | Matar A antes del envío | 1 | 1 | B tomó la tarea 4.291–4.371 ms después de la interrupción |
| S4 | Matar A tras la aceptación del receptor; sin clave | 2 | 2 | El efecto aceptado por A fue seguido por un segundo efecto de B |
| S5 | Mismo límite que S4; clave estable operationId | 2 | 1 | El receptor reconoció el request de B como duplicado |
| S6 | Congelar A tras la aceptación; dejar terminar a B y reanudar A | 2 | 1 | El resultado guardado siguió siendo el de B |
| S7 | Enviar SIGTERM a A después de iniciar la tarea | 1 | 1 | La liberación del lease permitió que B tomara la tarea en 281–285 ms |
| P1 | Adaptador anterior; clave activa; B inicia mientras A sigue trabajando | 2 | 1 | No se guardó dueño ni lease; B ejecutó mientras A seguía activo |
| P2 | Adaptador anterior; caso de dueño obsoleto con clave | 2 | 1 | B ejecutó al iniciar; el resultado guardado siguió siendo el de B |
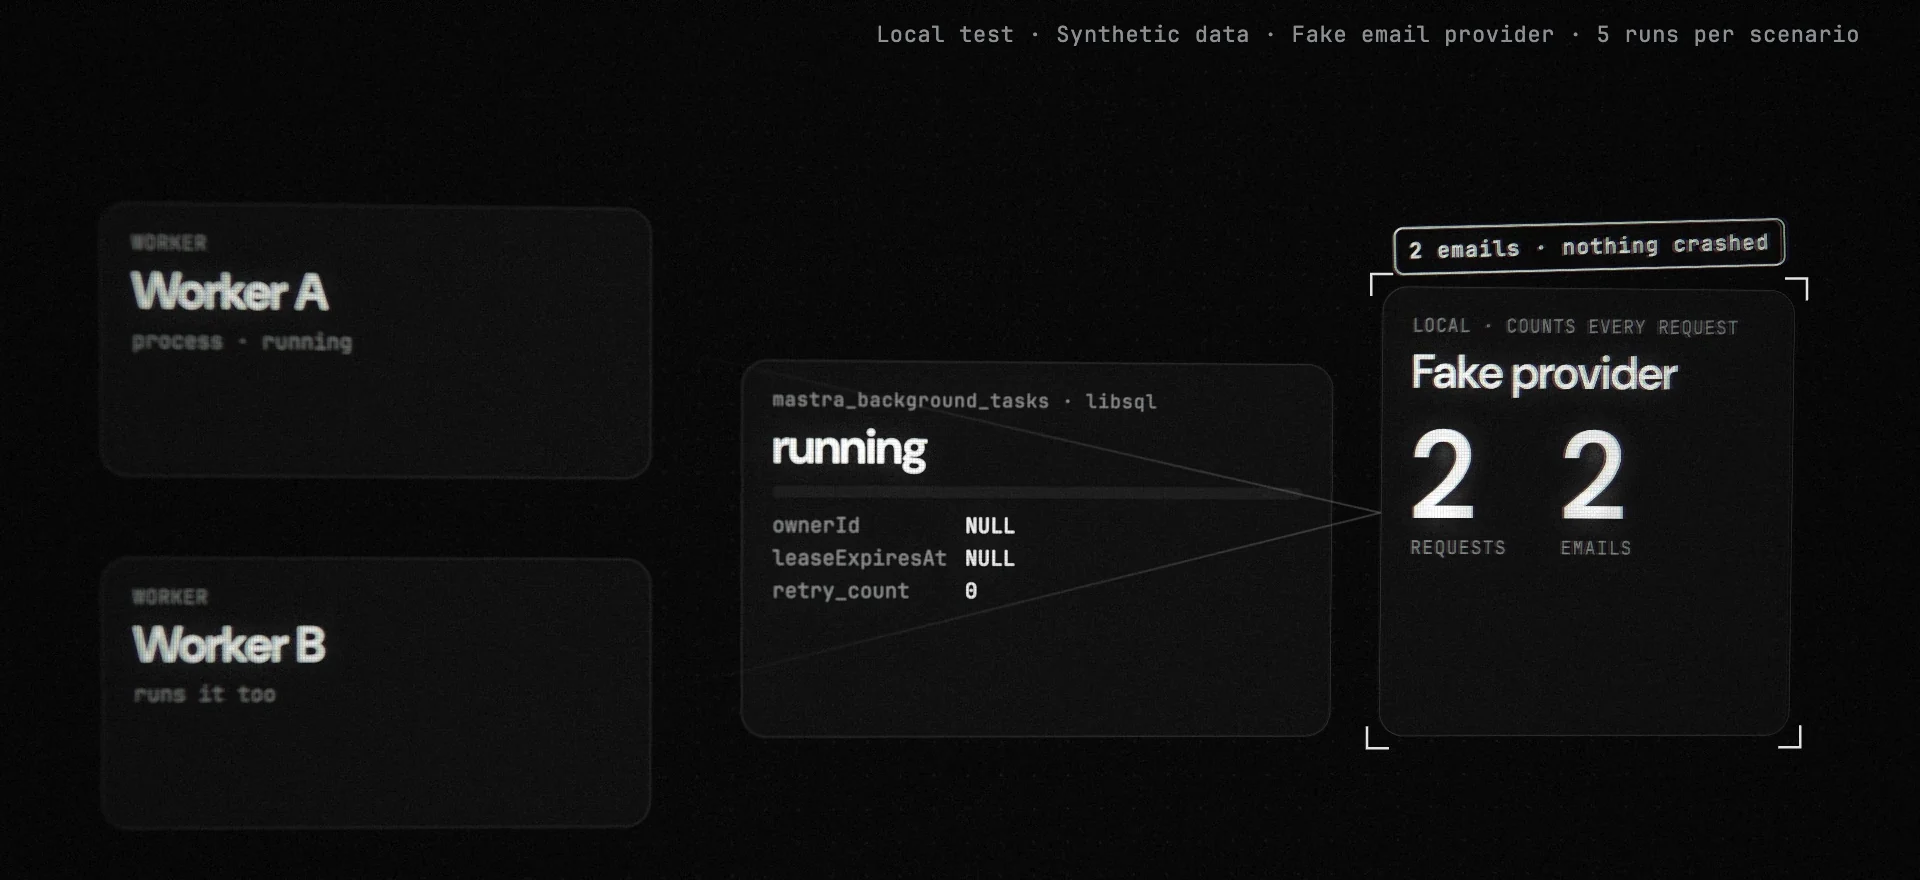
| P3 | Adaptador anterior; sin clave y sin caída | 2 | 2 | Ambos workers eran elegibles y se aceptaron los dos efectos |
La pareja actual de core y adaptador respetó un lease activo en S2 y recuperó la propiedad tras una interrupción en S3–S6. La ventana de takeover varió por escenario: con un lease de 4.000 ms, las cinco mediciones de S4 fueron de 3.979–4.007 ms después de la interrupción; una liberación ordenada en S7 redujo el tiempo a 281–285 ms. Son tiempos transcurridos observados, no una garantía de servicio derivada de la duración configurada del lease.
Los contadores también separan hechos que es fácil reunir bajo una sola etiqueta de «reintento». S4 y S5 hicieron dos solicitudes por corrida; su cantidad de efectos difirió porque solo el destino de S5 aplicó la clave. En todas las corridas recuperadas, retry_count siguió en cero, incluso cuando hubo dos ejecuciones de la herramienta. Ese campo no indicó cuántas veces la herramienta llamó al receptor.
El adaptador de almacenamiento forma parte de la garantía {#adapter}
Los escenarios con el adaptador anterior no son solo una comparación de números de versión. Prueban si la capa de almacenamiento participa realmente en el protocolo de propiedad. En este experimento, core 1.72.0 se instaló junto con @mastra/libsql@1.23.3 sin advertencia de peer dependency, pero las filas de tareas no persistieron dueño ni lease. Por eso B pudo ejecutar mientras A seguía activo.
P1 habilitó la clave de destino. Registró dos solicitudes y un efecto; B ejecutó mientras A estaba activo y el resultado guardado vino de A. P2 usó el caso de dueño obsoleto con clave: B ejecutó al iniciar, dos solicitudes llegaron al receptor, se aceptó un efecto y el resultado guardado vino de B. La clave evitó un segundo efecto en esas pruebas, pero no restauró el estado de propiedad de tarea que faltaba.
P3 quitó la clave y no mató a ningún worker. B seguía ejecutando mientras A estaba activo; el receptor registró dos solicitudes y dos efectos. No hacía falta que un proceso fallara para duplicar el trabajo externo cuando el adaptador no aplicaba la propiedad. En cambio, con la pareja probada, el dueño activo de S2 impidió que B ejecutara.
La comprobación práctica abarca la compatibilidad a ambos lados de la frontera: verifica que el adaptador elegido persista los campos y las actualizaciones condicionales de propiedad que requiere la versión de core. Que la instalación termine sin ruido no demuestra que el adaptador implemente el protocolo. Inspecciona la fila de tarea y las ejecuciones observadas; no deduzcas que hay enforcement del lease solo a partir de la versión del paquete core.
04 / Una corrida S4, evento por evento
Una corrida S4, evento por evento
El video explicativo de esta prueba sigue la corrida S4-1. Un clip y dos fotogramas muestran la misma frontera: se acepta la solicitud de A, A muere, B inicia unos cuatro segundos después y el proveedor cuenta un segundo correo. El seguimiento de cámara del clip es un tratamiento visual; el log de eventos que sigue es el registrado.
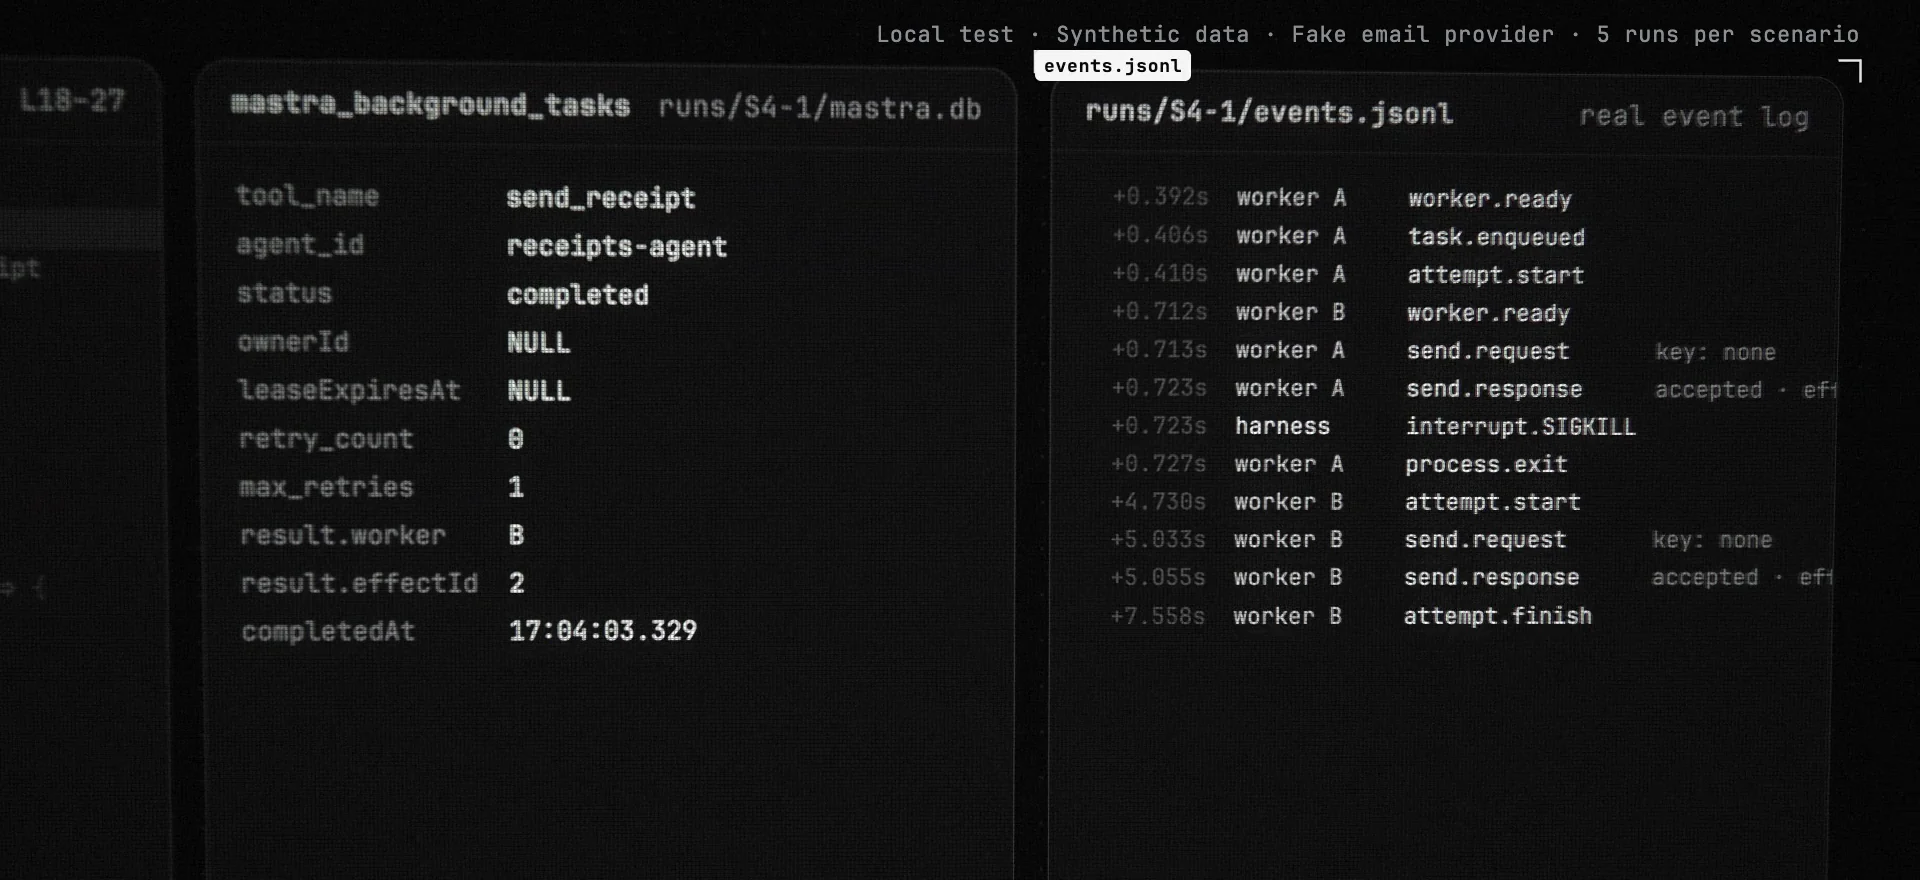
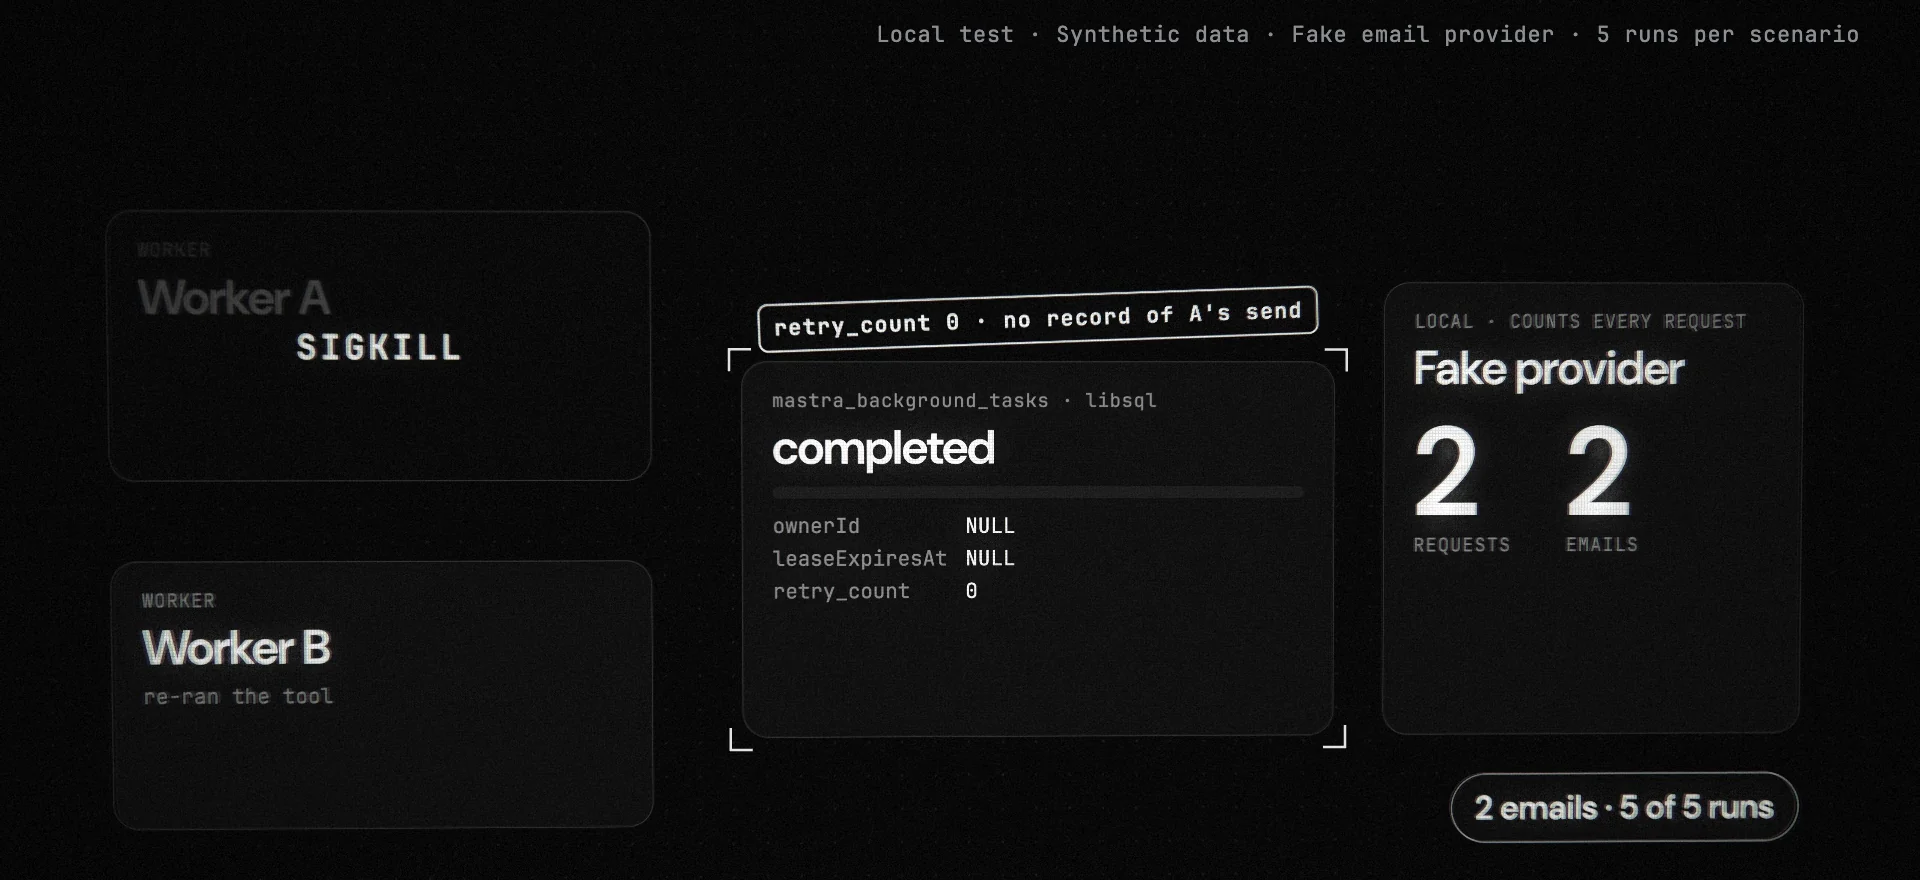
Los fotogramas anteriores provienen de S4-1. La figura siguiente abre otra repetición, S4-2, con tiempos exactos en vez de un ejemplo inventado: está registrada en runs/S4-2/record.json y los valores t del gráfico son milisegundos relativos al inicio de esa corrida. Las cinco corridas S4 produjeron dos solicitudes y dos efectos.
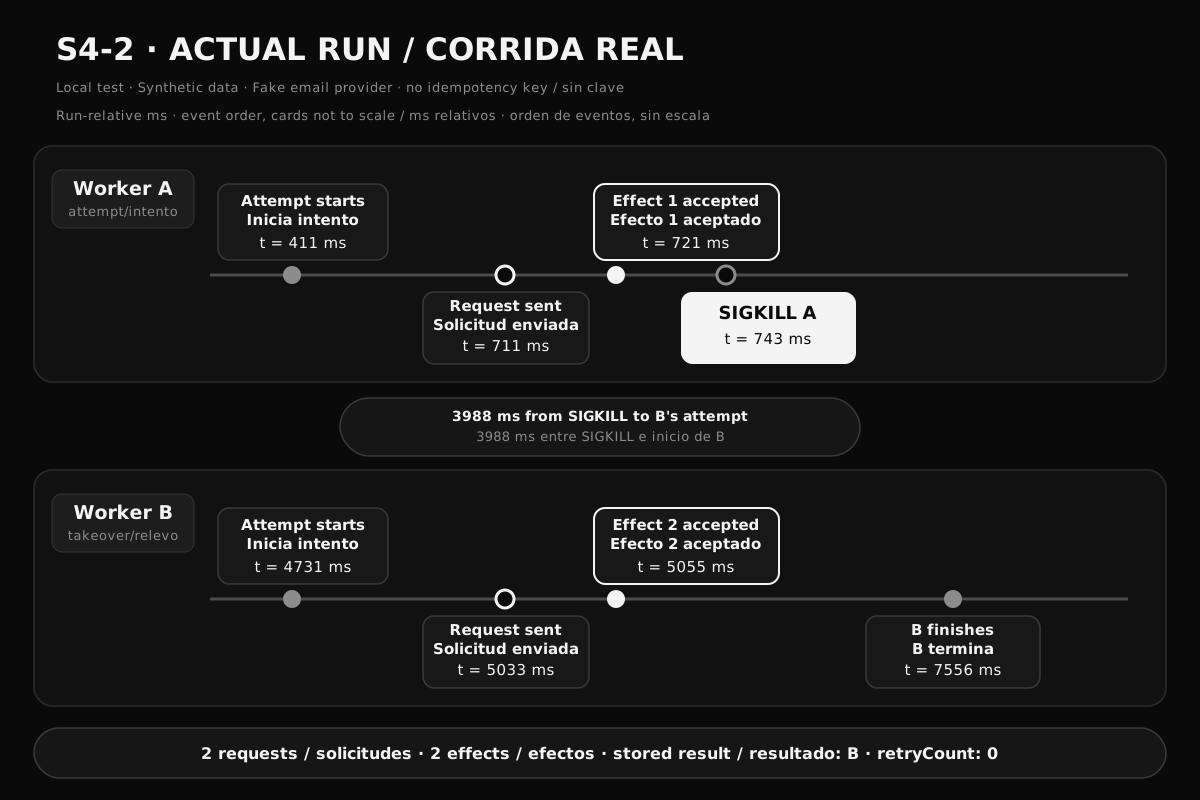
Inspeccionar el extracto saneado de eventos detrás de la línea de tiempo. El extracto omite identificadores locales de proceso y dueño; los nombres de evento, tiempos relativos, workers, resultados de aceptación e IDs de efecto se copiaron de la corrida registrada.
En t=711 ms, A envió la primera solicitud sin clave de idempotencia. En t=721 ms, la respuesta registrada fue aceptada como efecto 1. El orquestador envió SIGKILL en t=743 ms, 22 ms después de esa respuesta; A salió tres milisegundos más tarde. El efecto aceptado por el receptor ya estaba fuera del almacenamiento de tareas. Matar a A no podía retirarlo.
B comenzó su intento en t=4.731 ms, 3.988 ms después de la interrupción. Envió su solicitud en t=5.033 ms; en t=5.055 ms, el receptor aceptó el efecto 2 porque no había una clave. B terminó en t=7.556 ms y su resultado quedó guardado. El retryCount final de la tarea siguió en 0. En esta corrida, la recuperación funcionó: B completó la tarea. El efecto duplicado también quedó registrado en el destino.
Esta traza no sustituye el resultado de cinco corridas ni establece un tiempo universal. Demuestra el orden preciso de eventos en una repetición. El resultado agregado de S4 proviene de las cinco corridas registradas; la línea de tiempo permite inspeccionar una.
05 / La idempotencia cambia el número de efectos, no el de solicitudes
La idempotencia cambia el número de efectos, no el de solicitudes
S4 y S5 colocaron la interrupción en el mismo límite. En S4, el receptor aceptó la solicitud de A y A murió antes de guardar el resultado de la tarea. B la recuperó y volvió a enviar la operación. Sin una clave en el destino, el receptor aceptó el efecto 2. Ocurrió en las cinco repeticiones.
En S5, ambos intentos enviaron el mismo operationId estable como Idempotency-Key. El receptor siguió viendo dos solicitudes HTTP en cada corrida: la clave no impide que un worker haga otra llamada. Aceptó un solo efecto y marcó el request de B como duplicado en las cinco corridas. El experimento respalda una afirmación más acotada que «la tarea se ejecutó una vez»: la deduplicación implementada por el destino redujo dos solicitudes a un efecto aceptado.
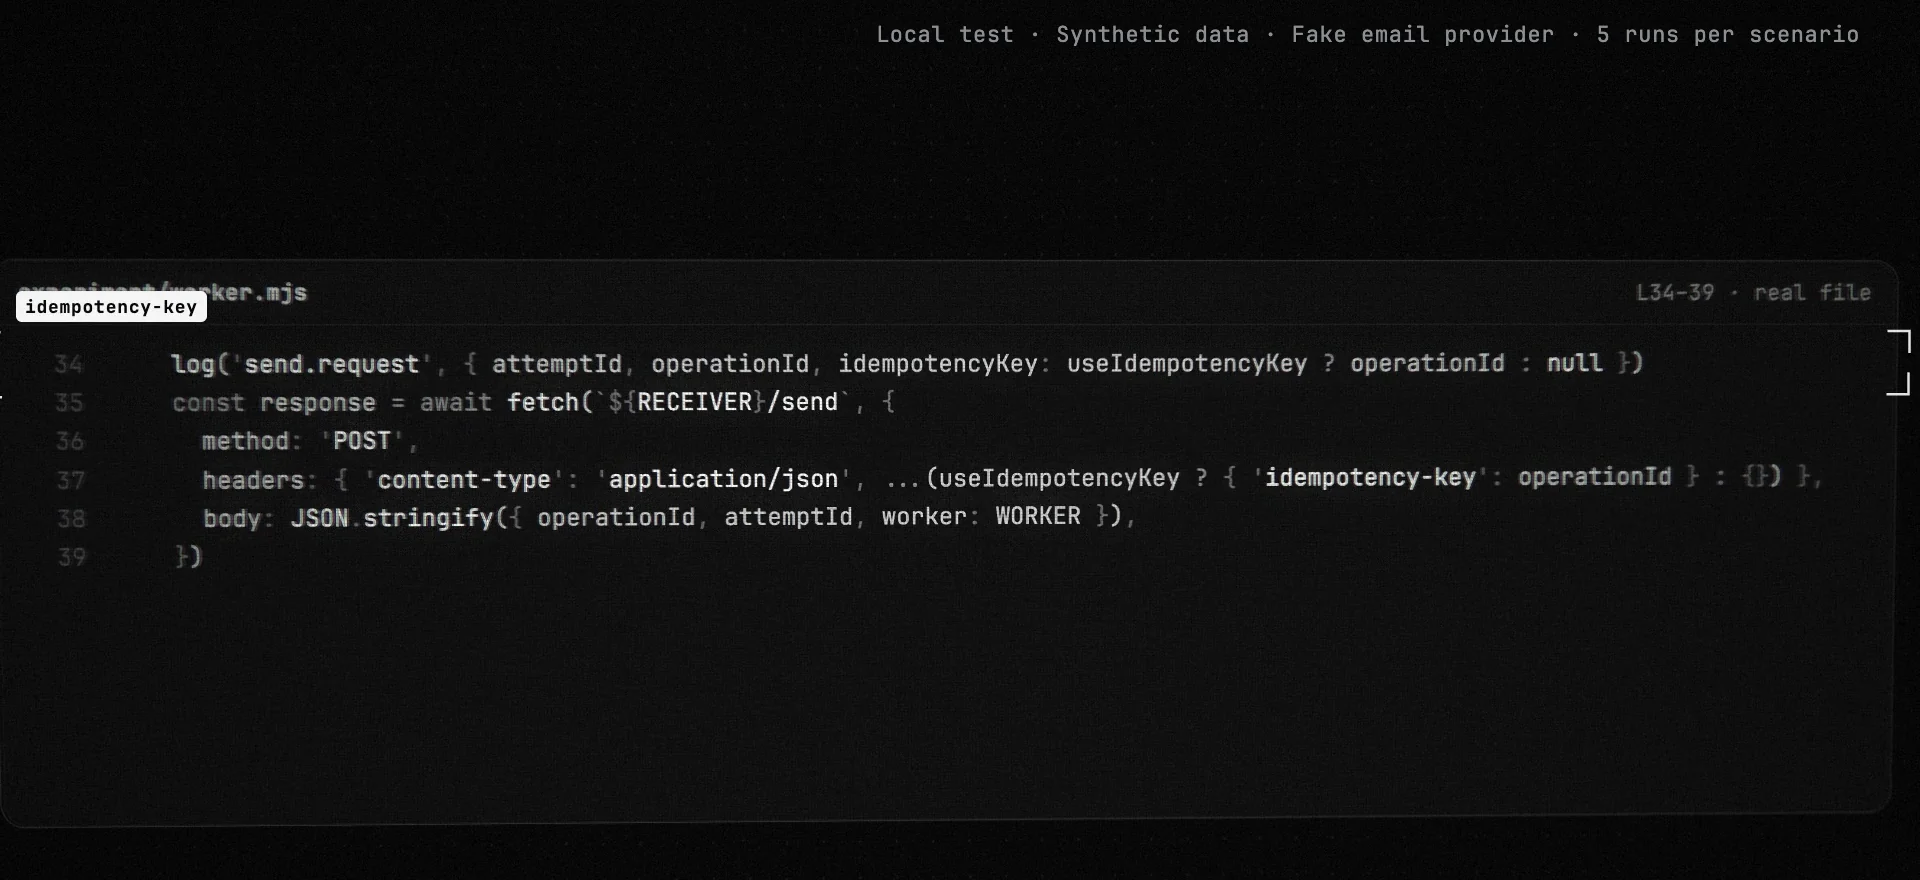
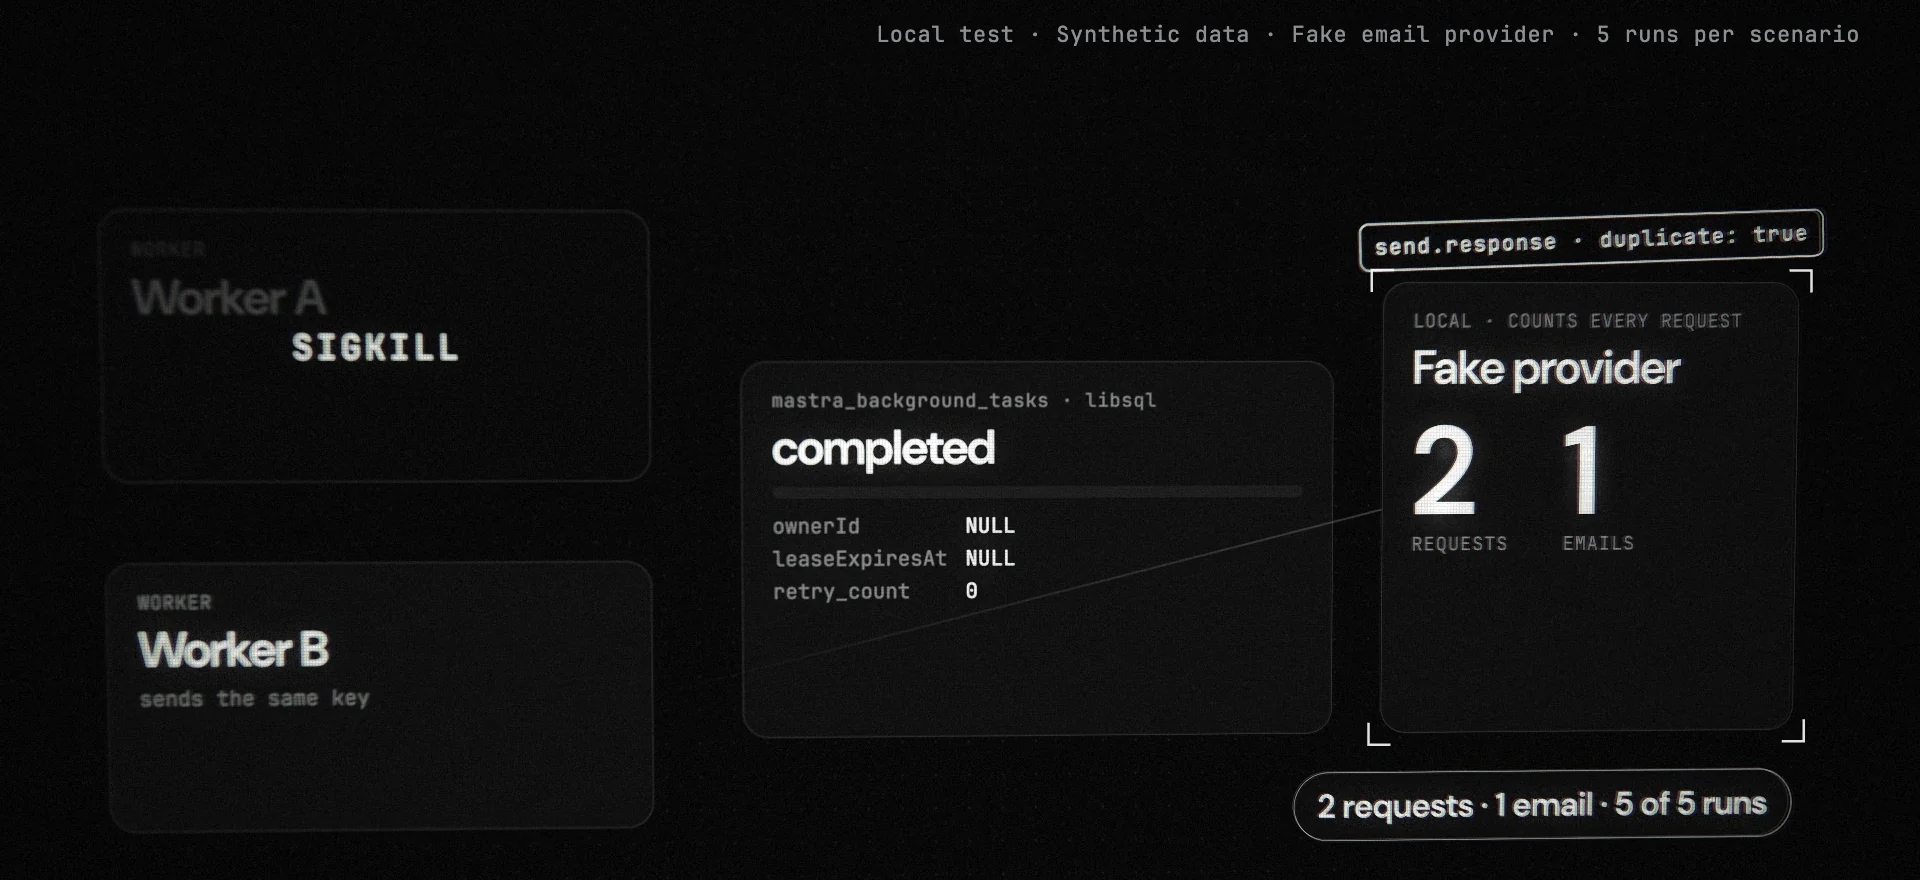
El alcance de la observación importa. El receptor de prueba usó una clave única y una inserción atómica; fue construido para respetar esa clave. Los proveedores reales definen su alcance, periodo de retención, tratamiento de conflictos y respuestas. Una clave que vence antes de un reintento, cambia entre intentos o que el destino ignora no produce el mismo resultado. El ID de operación lógica debe mantenerse estable entre intentos y su semántica debe corresponder al contrato del proveedor.
S6 probó otra propiedad independiente. A quedó pausado después de la aceptación; B recuperó la tarea y terminó, y luego A reanudó. Con una clave estable, el receptor registró dos solicitudes y un efecto; el resultado guardado de la tarea siguió siendo el de B en todas las repeticiones. La idempotencia limitó el efecto externo. La propiedad persistida impidió que el worker desplazado reemplazara el resultado completado. Ningún hecho sustituye al otro.
06 / Qué medir en una integración
Qué medir en una integración
Trata la recuperación de tareas, las llamadas salientes y los efectos del destino como observables separados. En el experimento, retry_count siguió en cero mientras el receptor veía dos solicitudes y, en S4, dos efectos. Un contador de una ruta interna de reintento no sustituye el conteo de intentos de tarea ni de resultados externos.
Para una integración real de correo, conserva un ID de operación estable para el mensaje lógico y envíalo como clave de idempotencia del proveedor en cada intento. Confirma el alcance y la retención documentados por ese proveedor en vez de suponer que un encabezado tiene semántica universal. Un reintento no debería crear otro ID de operación lógica solo porque la tarea cambió de dueño.
Valida directamente la ventana de fallo: primero confirma que un segundo worker no se ejecute mientras un adaptador compatible registra un dueño activo; después interrumpe el proceso una vez que el proveedor acepta la solicitud, pero antes de que se guarde el resultado de la tarea. Observa por separado los intentos de tarea, solicitudes HTTP, respuestas del proveedor y efectos entregados. Inspecciona también el dueño persistido y el resultado final cuando se reanude un worker obsoleto. Son invariantes distintos; comprobar uno no demuestra los demás.
El código revisado para este experimento también separa la política de recuperación del comportamiento de una clave: redistribuir una tarea obsoleta requiere maxRetries > 0; con maxRetries = 0, la tarea se marca como fallida en lugar de redistribuirse. Las 50 corridas usaron maxRetries = 1, así que ese comportamiento con cero reintentos es un hallazgo de código fuente, no un resultado medido en esta serie.
07 / Reproducir el experimento
Reproducir el experimento
El protocolo fijado describe el sistema, el comportamiento del destino, los escenarios, la evidencia recopilada y las reglas de clasificación. El agregado legible por máquina contiene los resultados de cinco corridas para los diez escenarios. No incluye las bases de datos ni los logs de cada corrida; el extracto enlazado de S4-2 es una vista pequeña y saneada de una corrida registrada.
El runner, el worker, el receptor, el analizador y los manifiestos de paquetes están disponibles como runner, worker, receptor, analizador, manifiesto del adaptador actual y manifiesto del adaptador anterior. Los sufijos .mjs.txt y .py.txt permiten servir el código como texto; cámbialos a .mjs y .py en la estructura indicada por el protocolo.
Usa Node v26.0.0 y registra las versiones que se resuelvan al repetir las corridas. Los manifiestos fijan las dependencias directas, no un lockfile transitivo. El runner elimina y vuelve a crear el directorio correspondiente runs/<scenario>-<rep>; ejecútalo en una copia de trabajo desechable, no junto a evidencia que debas conservar. El analizador genera un resumen a partir de los registros de cada corrida; al revisar su salida, conserva separados el conteo de solicitudes y el de efectos aceptados.
08 / Qué demuestra y qué no demuestra el resultado
Qué demuestra y qué no demuestra el resultado
El lease responde qué worker puede ser dueño de una tarea y completarla cuando el adaptador correspondiente persiste el límite de propiedad. La idempotencia del destino responde si un destino que respeta una clave estable ya aplicó la operación lógica. En esta prueba controlada, el lease coordinó la ejecución de tareas; la clave del receptor redujo los efectos aceptados sin bajar el número de solicitudes, que siguió en dos. Llamar a la recuperación de tareas una garantía de entrega «exactly-once» mezclaría dos garantías que el experimento mantuvo separadas.
La evidencia cubre un adaptador local libSQL, un receptor sintético, un Apple M5, Node v26.0.0 y cinco repeticiones por escenario. Basta para mostrar un comportamiento consistente en estas corridas, no para estimar una tasa de fallos en producción. No se probaron correos reales, proveedores, CRM, modelos, recuperación de durable agents, varios hosts ni otros adaptadores de almacenamiento. La idempotencia del receptor se implementó específicamente para el experimento; otros destinos pueden tener semánticas diferentes.
El resultado útil es una frontera de diseño, no una afirmación universal de entrega: recupera la propiedad de la tarea con un adaptador compatible y, por separado, haz que la operación externa pueda repetirse con una semántica que el destino realmente admita. Después prueba y observa ambas fronteras. La versión de Mastra y el cambio del adaptador en el PR #24841 describen el contexto de implementación; el protocolo y las mediciones adjuntos muestran qué hizo esta prueba concreta.
09 / Rastro de fuentes
Primarias, frescas, inspeccionables.
Los detalles de producto cambian rápido. Estas fuentes se verificaron para esta edición el 14 de octubre de 2026. Vuelve a verificar antes de cambiar una política de producción.
Señal semanal · correo quincenal
Ideas probadas en campo. Sin producir contenido por producir.
Una nota sustancial cuando tenemos algo que vale la pena mostrar: sistemas, evidencia, instrucciones y lo que falló. Confirma por correo. Cancela tu suscripción cuando quieras.